
Omni AI Video
Omni AI Video:強力なマルチモーダル動画生成ツール

Omni AI Videoとは何ですか
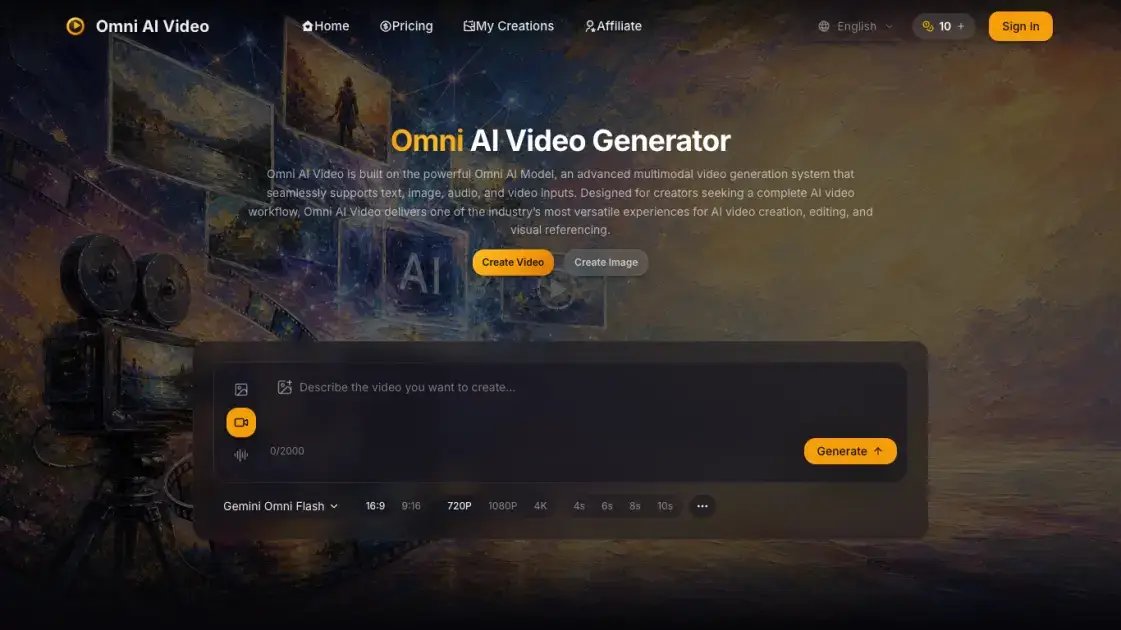
Omni AI Video は、Omni AI Model 上に構築されたマルチモーダル AI 動画ジェネレーターです。単一の統合ワークスペース内でテキスト、画像、音声、動画の入力をサポートしています。このプラットフォームは、クリエイターがテキストから動画、画像から動画、リファレンスから動画の生成によってビデオコンテンツを制作できるようにし、別々のツールを切り替える必要はありません。Omni AI Model は混合入力を処理し——自然言語プロンプト、視覚リファレンス、音声ヒントを組み合わせて——SNSコンテンツ、広告、製品ショーケース、商用プロジェクトに適した一貫性のある動画出力を生成します。ジェネレーターはユーザーを効率的なワークフローに導きます:ワークスペースを開き、テキストとオプションのリファレンスメディアでシーンを記述し、モデルを選択して生成します。プロンプトからプレビュー、最終エクスポートまで反復できるワークフローをサポートし、Omni AI Video は AI 駆動の動画制作のエンドツーエンドソリューションとして位置づけられています。コミュニティサポートは Discord 経由で、メールによる直接支援も利用可能です。
Omni AI Video はどのように機能しますか
Omni AI Model は統合されたマルチモーダルパイプラインとして機能します。ユーザーはジェネレーターのワークスペースを開き、 Desired シーンを記述する自然言語プロンプトを提供します。オプションで、ビジュアルスタイル、被写体の外見、モーションヒントをガイドするためにリファレンス画像、音声クリップ、ビデオセグメントをアップロードできます。選択されたモデルは、テキスト、画像、音声、リファレンスをすべてまとめて単一の生成パスで処理します。システムはワークスペース内でプレビューできるビデオドラフトを出力します。結果が要件を満たす場合、ユーザーは同じインターフェースから直接最終ビデオをエクスポートできます。
Omni AI Video の利点
Omni AI Video は、テキストから動画、画像から動画、リファレンスから動画など、複数のビデオ作成モードを単一のワークスペースに統合し、クリエイターのワークフローの断片化を削減します。マルチモーダル入力システムにより、単一の生成パスでテキスト、画像、音声、リファレンスクリップを組み合わせることができ、手動コンポジションなしで一貫性のある出力を生成します。出力はSNSコンテンツ、広告、商業プロジェクトでそのまま使用できる形式です。評価用の無料プランが用意されており、Discord によるコミュニティサポートとメールによる直接支援が利用可能です。ただし、ホームページに詳細な料金プランが公開されていないため、利用前のコスト評価が難しい場合があります。Discord 以外のソーシャルメディアでの存在は限定的です。
Omni AI Video の長所と短所
長所
- 統合ジェネレーターにより複数の作成モード間のツール切替が不要
- マルチモーダル入力でテキスト、画像、音声、動画を組み合わせ可能
- 購入前の評価用に無料プランあり
- プロダクションレディ出力で商業利用に適している
- プロンプトからプレビュー、エクスポートまでの反復ワークフロー
短所
- 詳細な料金プランがホームページに掲載されていない
- Discord以外のソーシャルメディアでの存在が限定的
- 動画の解像度や長さの制限に関する情報がない
- 公開APIや統合ドキュメントが見当たらない
Omni AI Video のコア機能
統合ジェネレーター
テキストから動画、画像から動画、リファレンスから動画が単一のジェネレーター内で動作し、異なるビデオ作成モード間でツールを切り替える必要がなくなります。
マルチモーダル入力サポート
Omni AI Model はテキスト、画像、音声、リファレンス動画クリップを同時に処理し、混合入力によって一貫性のある動画出力を生成します。
テキストから動画生成
自然言語プロンプトは、Omni Video Model によって、明確な動き、構図、視覚的方向を備えたシネマティックな動画に変換されます。
画像から動画アニメーション
リファレンス画像は、各フレームで被写体、スタイル、クリエイティブな意図を保ちながら、動的な動画シーケンスにアニメーション化されます。
リファレンスから動画
視覚リファレンスと音声ヒントはテキストプロンプトと組み合わせて動画生成をガイドし、最終出力に対して詳細なクリエイティブ制御を提供します。
プロダクションレディ出力
生成された動画は、追加の後処理なしで、SNSコンテンツ、広告、製品ショーケース、商用アプリケーションですぐに使用できる形式で出力されます。
反復ワークフロー
クリエイターは同じワークスペース内でプロンプトからプレビュー、最終エクスポートまで移行し、最終レンダーに進む前に各段階で出力を調整できます。
Omni AI Video の使用例
- SNSコンテンツ:テキストプロンプトやリファレンス画像を起点として、プラットフォーム向けのショート動画を生成します。
- 広告:テキストのブリーフィングとビジュアルリファレンスから、撮影なしで製品広告動画を制作します。
- 製品ショーケース:静的な製品画像をアニメーション化し、リアルな動きを加えることで、ダイナミックな製品デモ動画を作成します。
- 商用動画制作:テキストの指示、ブランド画像、音声リファレンスを組み合わせ、クライアント向けの動画コンテンツを生成します。
- クリエイティブプロトタイピング:最終制作前に複数のプロンプトやリファレンス入力をテストし、動画コンセプトを素早く反復します。
Omni AI Video の FAQ
Omni AI Video とは?
Omni AI Video は、Omni AI Model によるマルチモーダル AI 動画ジェネレーターです。テキスト、画像、音声、動画入力をサポートし、単一の統合ワークスペース内でビデオコンテンツの作成、編集、参照が可能です。
Omni AI Video は誰のために設計されていますか?
このプラットフォームは、SNSコンテンツ、広告、製品ショーケース、商用プロジェクトにAI生成動画が必要なクリエイターを対象としています。複数のビデオ作成ワークフローを単一のツールで実行したいユーザーのために構築されています。
Omni AI Video で動画を作成するにはどうすればいいですか?
omniaivideo.ai のジェネレーターにアクセスし、 Desired シーンを記述するテキストプロンプトを作成し、オプションでリファレンス画像や音声クリップをアップロードし、モデルを選択して「生成」をクリックします。結果は同じワークスペース内でプレビューおよびエクスポートできます。
Omni AI Model はどのような入力タイプをサポートしていますか?
Omni AI Model はテキストプロンプト、画像、音声クリップ、リファレンス動画セグメントを受け付けます。これらを単一の生成パスで組み合わせ、すべての提供された入力を反映した一貫性のある出力を生成できます。
Omni AI Video は他の AI 動画ジェネレーターに比べてどのような利点がありますか?
主な利点はその統合アプローチです:テキストから動画、画像から動画、リファレンスから動画がすべて1つのジェネレーターと1つのモデルで動作し、ツール切り替えが不要です。マルチモーダル入力サポートにより、単一のプロンプトでメディアタイプを混在させることもできます。
無料プランはありますか?
Omni AI Video はプラットフォームを評価するための無料プランを提供しています。有料プランも利用可能ですが、具体的な価格情報はホームページに掲載されていません。
サポートはどうすれば受けられますか?
サポートは Omni AI Video Discord コミュニティとメールアドレス support@omniaivideo.ai 経由で利用可能です。
Omni AI Videoの使用方法
- ジェネレーターを開く — omniaivideo.ai の AI 動画ジェネレーターにアクセスし、すべてのビデオ作成モードに対応する Omni AI Model ベースの統合ワークスペースを提供します。
- シーンを記述する — テキストプロンプトを作成し、オプションのリファレンス画像をアップロードし、目的のショットやスタイルに最適なモデルバリアントを選択します。
- 生成してエクスポート — 生成プロセスを開始し、ワークスペース内で結果の動画をプレビューし、必要な品質を満たしたら最終出力をエクスポートします。
Omni AI Video ウェブサイト・トラフィック分析
最新の交通情報
- 毎月の訪問数33.02K
- 直帰率38.08%
- 訪問ごとのページ数1.93
- 訪問期間00:00:37
- 世界ランク903.72K
- 国・地域ランキング202.87K
人気のキーワード
| キーワード | トラフィック | ボリューム | クリックあたりのコスト |
|---|---|---|---|
| omni video factory | 2.11K | 8.15K | $0.23 |
| elevenlabs | 1.9K | 3.27M | $0.2 |
| omni ai | 730 | 25.56K | $2.44 |
| omni ai video | 250 | 560 | -- |
| omni ai video generator | 120 | 810 | -- |
人気エリア
| 地域 | パーセンテージ |
|---|---|
| インド | 29.64% |
| アメリカ合衆国 | 11.52% |
| ブラジル | 10.21% |
| メキシコ | 7.52% |
| イギリス | 6.29% |
Omni AI Video 代替案
Seedance 3.0 のプレビューページ。マルチショットの連続性、シーン編集、音声と映像の同期を予定機能として紹介し、ページ内の生成ツールは現在 Seedance 2.5 で動作します。
クリエイター、マーケター、プロダクトチーム向けのブラウザワークスペース。AI画像生成、参考画像の編集、ショート動画のドラフト作成に対応します。
Black Forest Labsのマルチモーダルモデルをブラウザで使える生成ツール。テキストからの動画、画像からの動画、画像編集に対応し、音声も同時に生成する。クリエイターやマーケター向け。
Wan と Seedance の動画モデルをまとめて使える独立プラットフォーム。スペックと秒単価を比較し、Playground で生成、または 1 つの API から呼び出せます。
Seedance 3.0はテキスト・画像・動画クリップ・音声を音付きの動画にまとめ、クリップの指定箇所だけを修正して残りを作り直さずに済みます。
Weryは、1つの目標を動画・画像・音楽・ドキュメントの専門エージェントに振り分け、キャラクターやプロジェクト素材の一貫性を保つ仮想AIスタジオです。

テキストから動画、画像から動画、キーフレーム制御に対応したAI動画・画像スタジオ。Seedance、Kling、Wan、Viduなどを1つのクレジット残高で利用できる。
ブラウザで使えるAIスタジオ。動画・画像・音楽を生成でき、Grok Imagine、Kling、GPT Imageなどのモデルに対応。毎日無料クレジットが付与され、登録なしで利用できる。
SeaMove AI は、Seedance 2.0 と Seedance 2.5 モデルを提供する AI 動画・画像生成プラットフォームです。テキストから動画、画像から動画、参照ベースの作成に対応。クリエイターやスタジオ向けにマルチショットの連続性、ディレクター級の制御、音声同期機能を備えています。
2枚の別々の人物写真を、オレンジ色のステージと共有マイク、オリジナル音源を使った15秒の縦型ラップデュエット動画に変換します。無料の480Pプレビューを利用できます。
Mareelは、40以上の主要AIモデルを一つのワークスペースに集約したオールインワンの動画・画像生成ツールです。クリエイター、マーケター、ECチームが同じクレジット残高で利用できます。
Kinoviは、公開されている動画・画像・音声AIモデルを単一のエンドポイントで実行するREST APIです。モデルIDをcreateTaskに送り、recordInfoをポーリングして結果を取得し、共通のクレジット残高から従量課金されます。