
Seed Audio - AI テキスト読み上げと対話生成ツール

Seed Audioとは何ですか
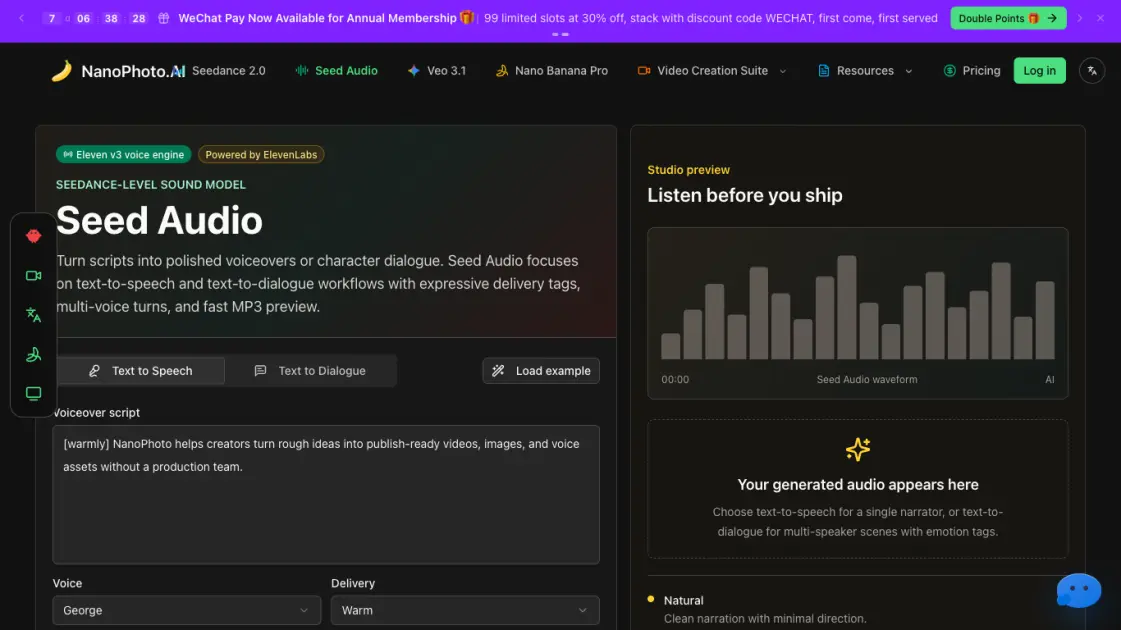
Seed Audio は、ElevenLabs のインフラストラクチャ上に構築されたテキスト読み上げおよび対話生成ツールで、NanoPhoto プラットフォームから利用できます。このサービスは、書き起こしスクリプトを MP3 オーディオに変換し、単一音声のナレーションと複数話者による割り当てボイス付き対話の 2 つの主要モードを提供します。
[laughing](笑い声)、[whispering](ささやき)、[sighs](ため息)、[short pause](短い間)などのパフォーマンスタグを使用して、表現スタイルを細かく制御できます。Natural(ナチュラル)、Warm(ウォーム)、Cinematic(シネマティック)の 3 つのプリセット方向性が、解説動画、予告編、オンボーディング資料など、さまざまなコンテンツタイプに合わせてペースとトーンを調整します。
ワークフローは「作成-指示-レンダリング-試聴-ダウンロード」のループで構成され、エクスポート前にブラウザ内で MP3 をプレビューできます。出力は、動画編集、ポッドキャストの下書き、広告モックアップ、製品デモなどに利用できます。
Seed Audio はどのように機能しますか
Seed Audio は、ElevenLabs のテキスト読み上げ(text-to-speech)およびテキスト対話(text-to-dialogue)モデルを活用した、簡素化された4ステップのワークフローで動作します。ユーザーはまずソーススクリプトを作成します。ナレーション用の単一パラグラフか、複数話者シーン向けの2〜4ターンの対話形式です。次に音声を選択します。テキスト読み上げモードでは1人のナレーター、対話モードでは各ターンに異なるキャラクターの声を割り当てます。[warmly](温かみを込めて)、[curious](好奇心旺盛に)、[laughing](笑いながら)、[whispering](ささやくように)、[sighs](ため息)、[short pause](短い間)などの演技タグが感情表現とテンポを指示します。最後にシステムがブラウザ上で再生可能な MP3 プレビューを生成し、ダウンロード前にすぐに試聴できます。動画編集、ポッドキャストの下書き、広告モックアップ、製品デモなどに利用できます。
Seed Audio の利点
Seed Audio は、テキスト読み上げと複数話者対応の対話生成を、ElevenLabs を搭載した単一のブラウザツールに統合し、個別のエディタを行き来する必要をなくします。[laughing]、[whispering]、[sighs]、[short pause] といったパフォーマンスタグにより、Natural、Warm、Cinematic の各話法スタイルにわたってきめ細かな感情制御が可能です。また、ターンごとに音声を割り当てられるため、ポッドキャスト、ゲームプロトタイプ、ストーリーボードデモで信頼性の高いキャラクター間の対話を実現します。記述から指示、レンダリング、試聴、ダウンロードまでの一貫したワークフローにより、公開可能な MP3 を数秒で生成できます。ただし、ワークフローは ElevenLabs の音声ライブラリに限定されており、カスタム音声トレーニング、API アクセス、バッチ処理には対応していません。また、年間 668 ドルの価格帯は、気軽な実験用途としては高めです。
Seed Audio の長所と短所
メリット
- TTS(テキスト読み上げ)と対話生成を1つのツールに統合
- パフォーマンスタグで感情や話し方を制御
- 複数話者による対話シーンと話者割り当てに対応
- ブラウザ上で高速MP3プレビューとダウンロード
- 3つの話し方スタイル:Natural、Warm、Cinematic
デメリット
- ElevenLabsアカウントが必要
- クレジット制の料金モデルで使用量が制限される
- 音声のみの出力で動画同期は非対応
- カスタム音声クローン機能については言及なし
- Web版のみでオフライン非対応
Seed Audio のコア機能
テキスト読み上げ生成
スクリプト、フック、解説、短い広告読み上げから、クリーンで自然なナレーション音声を生成します。
テキスト対話生成
デモ、ポッドキャスト、ゲーム、ストーリーボード向けに、各ターンに異なる声を割り当てて複数話者の会話を作成します。
パフォーマンスタグ
[laughing](笑い)、[whispering](ささやき)、[sighs](ため息)、[short pause](短い間)などのインラインタグを使用して、表現豊かな音声を制御します。
読み上げスタイルプリセット
Natural(自然)はクリーンな朗読、Warm(温かみ)は親しみやすい解説、Cinematic(映画的)は劇的なテンポという3つのプリセットスタイルを提供します。
ターンごとの音声選択
対話の各ターンに個別の音声を割り当てることができ、複数話者シーンで説得力のあるキャラクターのやりとりを実現します。
MP3 プレビューとダウンロード
音声を MP3 にレンダリングしてブラウザ内で再生し、ビデオ編集、ポッドキャストの下書き、デモ用のダウンロードファイルを提供します。
Seed Audio の使用例
- コンテンツクリエイター:表現豊かな配信タグを使用して、動画編集、予告編、ストーリーボードのナレーションを生成
- ポッドキャスター:マルチボイス対話生成を使用して、ポッドキャストの下書きと複数話者の対話エピソードを制作
- 広告主:温かみのある、シネマティック、または自然な配信スタイルで、広告モックアップと製品デモのナレーションを作成
- ゲーム開発者:ゲームプロトタイプとストーリーボードのキャラクターボイスとナレーションを生成
- 動画編集者:ラフカット、クライアントレビュー、最終動画書き出し用のナレーション下書きを迅速に制作
Seed Audio の FAQ
Seed Audio とは?
Seed Audio は、ElevenLabs の技術をベースに NanoPhoto プラットフォームに統合された、AI による音声合成(Text-to-Speech)およびテキスト対話生成ツールです。書き起こしたスクリプトを、表情豊かなパフォーマンスタグ、マルチボイスでの対話対応、高速 MP3 プレビューに対応した音声に変換します。ユーザーはスクリプトを入力し、音声を選択し、必要に応じて演出指示を追加するだけで、ブラウザから離れることなく数秒で聞き取り可能な音声を生成できます。
テキスト読み上げとテキスト対話生成の違いは?
テキスト読み上げ(TTS)は、1 つのテキストブロックから単一のナレーターによる音声を生成し、解説動画、広告読み上げ、ナレーション下書きに適しています。テキスト対話生成は、スクリプト内の個々の発言ターンに異なる音声を割り当て、ポッドキャスト、ゲームの台詞、デモ、ストーリーボード向けの複数話者による会話をサポートします。対話モードではターンごとにパフォーマンスタグも指定できるため、各キャラクターの演技を個別に演出できます。
どのようなパフォーマンスタグがサポートされていますか?
Seed Audio は [laughing]、[whispering]、[sighs]、[short pause]、[warmly]、[curious] などのタグを認識し、出力の感情的なトーンやペースを調整します。これらのタグは、演出を変えたい箇所のスクリプトテキストに直接挿入します。TTS モードと対話モードの両方で機能し、外部の音声編集ソフトを使わずに、細かいニュアンスまでコントロールできます。
Seed Audio の料金体系は?
Seed Audio はクレジットベースの料金モデルを採用しており、1 回の音声生成につき 1 クレジットを消費します。クレジットは NanoPhoto プラットフォームを通じて購入し、製品スイート全体で使用できます。この従量制モデルは、ワークロードが変動するユーザーに適しており、月額契約なしで、時折のナレーション作成から大量の対話生成まで対応できます。
Seed Audio は誰に向けた製品ですか?
Seed Audio は、迅速に公開可能な音声アセットを必要とするコンテンツ制作者、動画編集者、ポッドキャスター、ゲーム開発者、プロダクトチームをターゲットとしています。広告のモックアップ、チュートリアルのナレーション、インディーゲームのキャラクター対話、ポッドキャストの下書き録音など、スピードが求められるワークフローに適しています。これまでは短いスクリプトごとに専用の音声スタジオを立ち上げていたユーザーも、同じ作業をはるかに短い時間で完了できます。
Seed Audio はどの音声形式を出力しますか?
Seed Audio は MP3 ファイルを生成します。ブラウザ上で直接プレビューし、動画編集ソフト、ポッドキャスト制作ツール、ゲームエンジン、プレゼンテーション資料にダウンロードして使用できます。MP3 はファイルサイズと音質のバランスが良く、クイックドラフトから最終アセットまで実用的に使える出力形式として採用されています。
Seed Audio は単体の TTS ツールとどう違いますか?
スクリプト編集、音声選択、音声エクスポートのたびにアプリケーションを切り替える必要がある単体の TTS ツールとは異なり、Seed Audio はすべての作業を NanoPhoto プラットフォーム内で完結します。ユーザーは 1 つのインターフェースでスクリプト作成、演出、レンダリング、試聴、ダウンロードまで行えます。内蔵のパフォーマンスタグシステムとマルチスピーカー対話モードにより、基本的な演出調整のために別途音声編集を行う必要がなくなり、1 回の反復時間が数分から数秒に短縮されます。
Seed Audioの使用方法
- ナレーションパラグラフを入力するか、2〜4 ターンのダイアログ(自然会話に焦点を当てた 4 ターンの対話)を入力して、ソーススクリプトを作成します。
- ナレーターボイスを選んでテキスト読み上げ(TTS)を行うか、各ダイアログターンに異なるボイスを割り当ててキャラクターの掛け合いを実現します。
- [warmly]、[curious]、[laughing]、[short pause] などのパフォーマンスタグを追加して感情表現をガイドし、演出されたような出力を得られます。
- ブラウザで生成された MP3 をプレビューして品質を確認し、オーディオファイルをダウンロードして動画編集、ポッドキャストの下書き、広告モックアップ、製品デモに使用します。
Seed Audio ウェブサイト・トラフィック分析
最新の交通情報
- 毎月の訪問数127.48K
- 直帰率40.7%
- 訪問ごとのページ数1.76
- 訪問期間00:00:37
- 世界ランク340.66K
- 国・地域ランキング33.75K
人気のキーワード
| キーワード | トラフィック | ボリューム | クリックあたりのコスト |
|---|---|---|---|
| nano banana | 380 | 1.64M | $0.7 |
| 视频提示词反推 | 320 | 310 | -- |
| nano photo ai | 240 | 240 | -- |
| subtitle remover | 230 | 2.2K | $0.2 |
| nanophoto ai | 230 | 490 | -- |
人気エリア
| 地域 | パーセンテージ |
|---|---|
| 中国 | 49.75% |
| アメリカ合衆国 | 4.69% |
| マレーシア | 3.47% |
| 台湾 | 3.14% |
| インド | 2.22% |
Seed Audio 代替案
MixVioは、ブラウザ型のワークスペースで21の動画・画像・音声モデルを実行し、11のクリエイター向けツールを提供します。生成前に正確なクレジット数が表示されます。
PodcastorAIはPDF、URL、ノート、音声をYouTube、Spotify、TikTok向けの高品質な動画ポッドキャストに変換。AIホスト、AI音声、スクリプト生成を搭載。
Miso One AI は、クリエイターや開発チームが表現力のある対話音声を生成し、クローンテストやプロンプトの確認、クレジット管理付きで音声サンプルをダウンロードできる AI ボイスジェネレーターです。

Petti Chat は AI 搭載のウェブツールで、飼い主が短いペットの鳴き声を取得し、その意図を人間の言葉に解釈し、落ち着いたペットフレンドリーな音声で返信できるようにします。プライバシーを保護し、リアルタイムでのやり取りが可能です。
GPT Realtime 2 は開発者とプロダクトチーム向けの AI 音声生成ツールで、リアルタイム音声対話、低遅延オーディオ、プロンプト制御、ツールハンドオフ、セッション録音のダウンロードが可能です。
GPT Realtime は開発者やプロダクトチーム向けの AI 音声生成プラットフォームで、低遅延の音声間変換、画像対応プロンプト、SIP 通話サポート、API ワークフロー設計、再利用可能なキャッシュを備え、音声アプリの高速プロトタイピングを実現します。
このオンライン PDF 音声リーダーは、OCR を介したスキャンファイルを含む文書を 142 以上の言語で自然な音声に変換し、すべての PDF 形式をサポートします。
AnySpeechは、プロフェッショナルなAIテキスト読み上げプラットフォームで、50以上の言語で100種類以上のリアルな音声を提供し、世界中のコンテンツクリエイター、YouTuber、ポッドキャスターのために設計されています。