

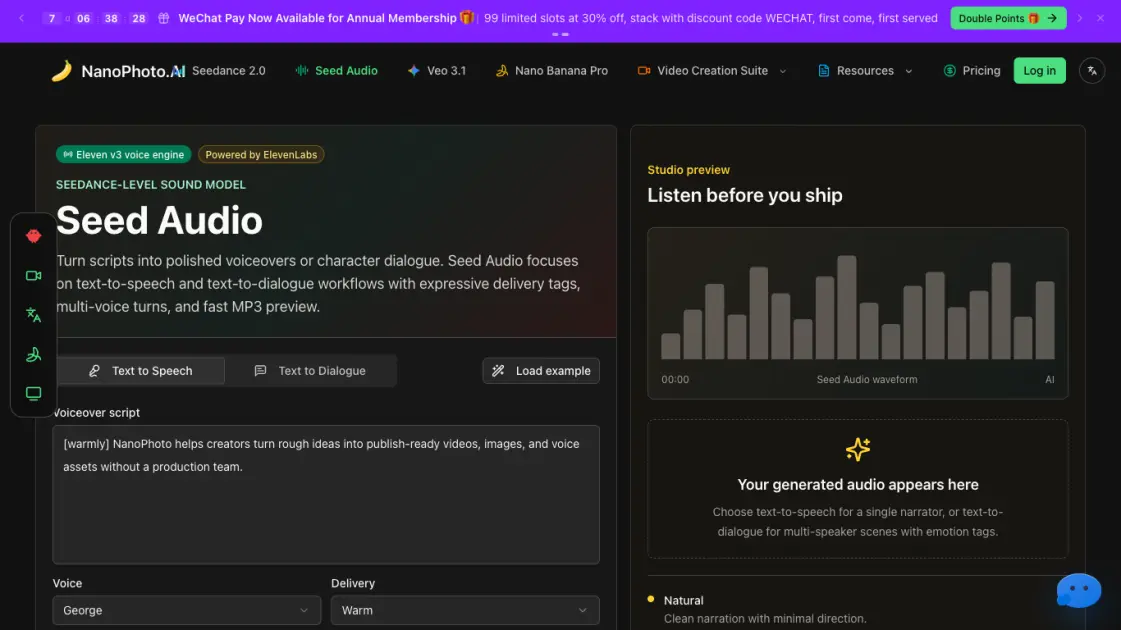
Seed Audio 是什么
Seed Audio 是一个基于 ElevenLabs 基础设施构建的文本转语音和对话生成工具,通过 NanoPhoto 平台即可使用。该服务将书面脚本转换为 MP3 音频,提供两种主要模式:单人旁白和多人对话(可分配语音角色)。
[laughing](笑声)、[whispering](低语)、[sighs](叹息)和 [short pause](短暂停顿)等表演标签让用户能够精细控制表达风格。Natural(自然)、Warm(温暖)和 Cinematic(电影感)三种预设方向可针对不同类型内容(如解说视频、预告片、新手引导材料)调整语速和语气。
工作流程遵循"编写-导演-渲染-试听-下载"的循环,导出前可在浏览器中预览 MP3。输出内容可用于视频剪辑、播客草稿、广告样片和产品演示。
Seed Audio 如何工作
Seed Audio 通过由 ElevenLabs 文本转语音和文本转对话模型驱动的精简四步流程运作。用户首先编写源脚本——可以是单段旁白,也可以是多说话人场景中的两到四轮对话。接下来选择声音:在文本转语音模式下选择一位叙述者,或者在对话模式下为每一轮对话分配不同的角色声音。[warmly](温暖地)、[curious](好奇地)、[laughing](笑着)、[whispering](低语)、[sighs](叹息)和 [short pause](短暂停顿)等表演标签控制情感表达和节奏。最后,系统生成可在浏览器中播放的 MP3 预览,用户可以在下载前即时试听,用于视频剪辑、播客草稿、广告样片或产品演示。
Seed Audio 的优势
Seed Audio 将文本转语音和多说话人对话生成整合到由 ElevenLabs 驱动的单一浏览器工具中,无需在多个编辑器间切换。[laughing]、[whispering]、[sighs] 和 [short pause] 等表演标签可在 Natural、Warm 和 Cinematic 三种演绎风格中提供细致的情感控制,而逐轮语音分配功能则为播客、游戏原型和分镜演示创建可信的角色对话。紧密的编写-导演-渲染-聆听-下载循环可在数秒内生成可直接发布的 MP3,不过工作流仍局限于 ElevenLabs 的语音库,不支持自定义语音训练、API 访问或批处理,且 668 美元的年费定价高于随意试用的范畴。
Seed Audio 的优点和缺点
优点
- 将 TTS(文本转语音)和对话生成整合在一个工具中
- 性能标签控制情感和表达方式
- 多角色语音对话场景和话轮分配
- 快速生成 MP3 预览并在浏览器中下载
- 三种表达风格:Natural、Warm、Cinematic
缺点
- 需要 ElevenLabs 账户才能生成
- 基于信用点的定价模式限制了使用量
- 仅输出音频,不支持视频同步
- 未提及自定义语音克隆功能
- 仅支持网页版,无离线功能
Seed Audio 的核心功能
文本转语音生成
根据脚本、钩子、解说词和短广告配音,生成清晰自然的单人旁白语音。
文本转对话生成
通过为每一轮对话分配不同的声音,为演示、播客、游戏和故事板创建多人对话。
表演标签
使用行内标签(如 [laughing] 笑声、[whispering] 低语、[sighs] 叹息、[short pause] 短停顿)来控制语音表现力。
朗读风格预设
提供三种预设风格:Natural(自然)用于清晰朗读,Warm(温暖)用于友好解说,Cinematic(电影感)用于戏剧化节奏。
逐轮语音选择
允许为每轮对话单独选择语音,在多说话人场景中实现可信的角色对话。
MP3 预览与下载
将音频渲染为 MP3 格式,支持浏览器内播放,并提供可下载文件,用于视频剪辑、播客草稿和演示。
Seed Audio 的用例
- 内容创作者:使用富有表现力的投递标签为视频剪辑、预告片和分镜脚本生成配音
- 播客制作人:使用多语音对话生成功能制作播客草稿和多说话人对话剧集
- 广告商:使用温暖、电影感或自然的投递风格创建广告样机和产品演示配音
- 游戏开发者:为游戏原型和分镜脚本生成角色对话和旁白配音
- 视频编辑:为粗剪、客户评审和最终视频导出快速制作配音草稿
Seed Audio 的常见问题解答
什么是 Seed Audio?
Seed Audio 是一个基于 ElevenLabs 技术并集成到 NanoPhoto 平台的 AI 语音合成(Text-to-Speech)与文本转对话工具。它可以将书面脚本转换为带有表情化表演标签、多角色对话支持和快速 MP3 预览的口语音频。用户编写或粘贴脚本,选择语音,可选添加表演指示,无需离开浏览器即可在数秒内生成可听的音频。
文本转语音和文本转对话有什么区别?
文本转语音(TTS)从一段文本生成单个叙述者旁白,适合解说视频、广告配音和旁白草稿。文本转对话则为一篇脚本中的不同话轮分配不同的语音,支持多说话者对话,适用于播客、游戏对白、演示和故事板。对话模式还支持每轮表演标签,每个角色的表演可以独立指导。
支持哪些表演标签?
Seed Audio 识别诸如 [laughing]、[whispering]、[sighs]、[short pause]、[warmly]、[curious] 等标签,这些标签可以控制输出的情感基调和节奏。标签直接插入到脚本文本中需要改变表演的位置。它们同时适用于 TTS 和对话模式,让用户无需外部音频编辑即可精细控制某句话的听感。
Seed Audio 如何计费?
Seed Audio 采用基于点数的计费模式,每次音频生成消耗 1 个点数。点数通过 NanoPhoto 平台购买,并在产品套件中通用。这种按次付费的模式适合工作量不固定的用户,无论是偶尔的旁白草稿还是高容量的对话制作,都无需订阅月度套餐。
Seed Audio 为谁设计?
Seed Audio 面向内容创作者、视频编辑、播客制作者、游戏开发者和产品团队,他们需要快速可用的语音素材。它适合速度至上的工作流程,如广告原型、教程配音、独立游戏的角色对话和播客草稿录制。那些原本需要打开专业音频软件来处理每一段短脚本的用户,可以用它大幅缩短完成时间。
Seed Audio 输出哪些音频格式?
Seed Audio 生成 MP3 文件,可在浏览器中直接预览并下载,用于视频编辑软件、播客制作工具、游戏引擎和演示文稿。选择 MP3 作为输出格式,是因为它在文件大小和音频质量之间取得了良好平衡,既适合快速草稿,也适合最终成品。
Seed Audio 与独立 TTS 工具有何不同?
与需要在脚本编辑、语音选择和音频导出之间切换应用的独立 TTS 工具不同,Seed Audio 将整个工作流程保留在 NanoPhoto 平台内。用户在同一界面中编写、指导、渲染、试听和下载。内置的表演标签系统和多说话者对话模式无需为了基本的表演调整而进行额外的音频编辑,使得每次迭代时间从数分钟缩短到数秒。
如何使用 Seed Audio
- 通过输入旁白段落或两到四轮对话来编写源脚本,也可以写四轮专注于自然语音的对话。
- 选择叙述者语音进行文本转语音(TTS),或为每轮对话分配不同语音来实现角色对话,从而选择语音和表达方式。
- 添加 [warmly]、[curious]、[laughing] 或 [short pause] 等表演标签来引导情感表达,让输出听起来像有人导演过一样。
- 在浏览器中预览生成的 MP3 以检查质量,然后下载音频文件用于视频剪辑、播客草稿、广告样片或产品演示。
Seed Audio 网站流量分析
最新流量信息
- 每月访问量127.48K
- 跳出率40.7%
- 每次访问页数1.76
- 访问时长00:00:37
- 全球排名340.66K
- 国家/地区排名33.75K
热门关键词
| 关键词 | 流量 | 搜索量 | 每次点击费用 |
|---|---|---|---|
| nano banana | 380 | 1.64M | $0.7 |
| 视频提示词反推 | 320 | 310 | -- |
| nano photo ai | 240 | 240 | -- |
| subtitle remover | 230 | 2.2K | $0.2 |
| nanophoto ai | 230 | 490 | -- |
热门地区
| 地区 | 百分比 |
|---|---|
| 中国 | 49.75% |
| 美国 | 4.69% |
| 马来西亚 | 3.47% |
| 台湾 | 3.14% |
| 印度 | 2.22% |
Seed Audio 替代品
MixVio 在一个浏览器工作台中运行 21 个视频、图片与音频模型,并提供 11 个创作者工具,每次生成前都会显示确切的积分消耗。
PodcastorAI 可将 PDF、网址、笔记和音频转换为适合 YouTube、Spotify 和 TikTok 的 Studio 级视频播客,支持 AI 主持人、AI 语音和脚本生成。
Miso One AI 是一款 AI 语音生成工具,帮助创作者和开发团队生成富有表现力的对话音频、测试克隆、审阅提示并在信用追踪下下载语音样本。

Petti Chat 是一款基于 AI 的网页工具,帮助宠物主人捕捉短暂的宠物声音,解析可能的意图并转化为人类语言,随后以平静、适合宠物的音频进行回复,确保隐私并实现实时互动。
GPT Realtime 2 是面向开发者和产品团队的 AI 语音生成工具,提供实时语音转语音交互、低延迟音频、提示控制、工具交接以及会话录音下载功能。
GPT Realtime 是面向开发者和产品团队的 AI 语音生成平台,提供低延迟的语音转语音、支持图像的提示、SIP 呼叫、API 工作流规划以及可复用缓存,帮助快速原型化语音应用。