
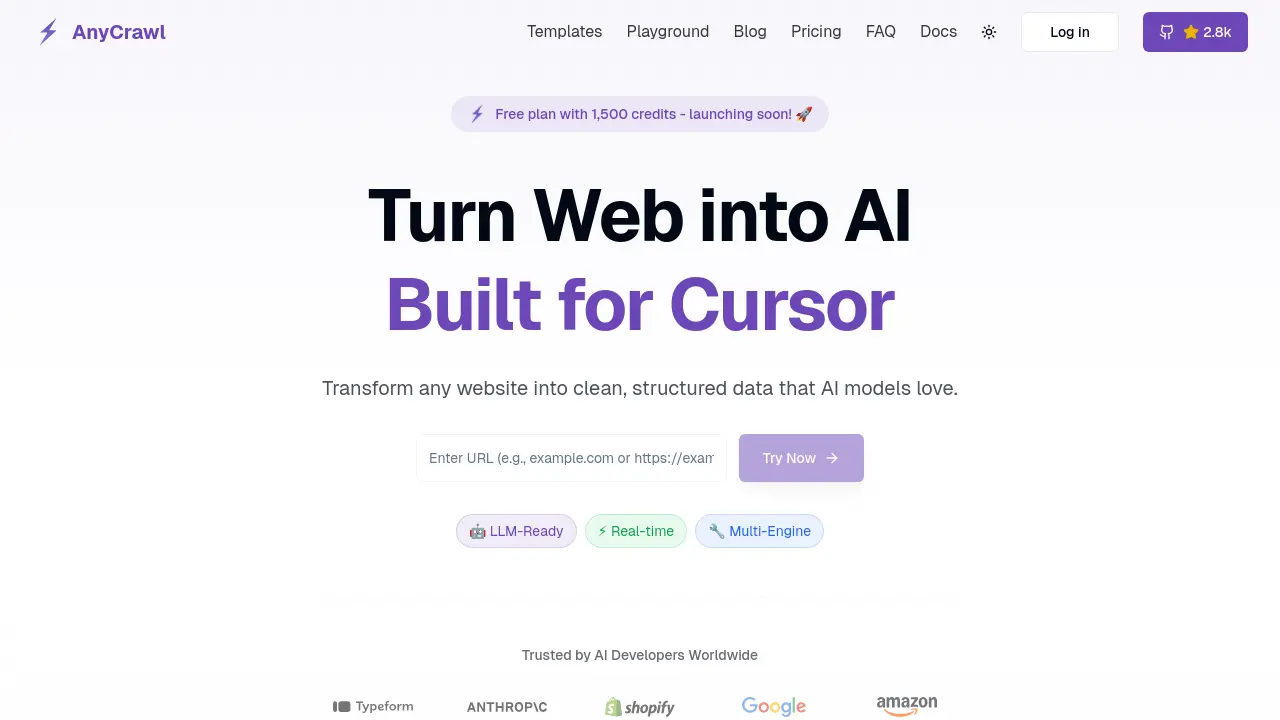
AnyCrawl преобразует веб-сайты в данные, готовые для LLM.

Что такое AnyCrawl
AnyCrawl — это веб-скрапер на базе Node.js/TypeScript, предназначенный для преобразования веб-сайтов в структурированные данные, готовые для LLM. Он обеспечивает высокопроизводительный сбор данных с функциями, такими как многопоточность, рендеринг JavaScript и всесторонняя поддержка API. Инструмент обрабатывает динамический контент и предоставляет чистый, организованный вывод, подходящий для ИИ-приложений и обработки данных. С надежностью корпоративного уровня и открытой лицензией AnyCrawl ориентирован на разработчиков и компании, которым требуется эффективное извлечение веб-данных. Он поддерживает различные форматы данных, конфигурации ротации прокси и предлагает гибкие тарифные планы, включая бесплатный уровень с 1 500 кредитами в месяц. Платформа заслужила доверие тысяч пользователей по всему миру благодаря скорости, надежности и данным, оптимизированным для ИИ.
Как работает AnyCrawl
AnyCrawl — это инструмент для веб-скрапинга, предназначенный для преобразования веб-сайтов в структурированные данные, готовые для использования с LLM. Он использует многопоточную архитектуру для обеспечения высокой производительности сканирования, способной обрабатывать сложные сайты и извлекать большие объёмы данных. Платформа поддерживает сайты с тяжёлым JavaScript через свой движок Playwright, что позволяет извлекать динамический контент с современных веб-приложений. AnyCrawl предоставляет удобный для разработчиков API с полными спецификациями OpenAPI, позволяя бесшовную интеграцию в приложения. Пользователи могут получить доступ к услуге через Docker без какой-либо настройки, и он предлагает структурированный вывод данных в чистых форматах, включая markdown и JSON, оптимизированных для потребления ИИ и LLM. Этот инструмент является открытым исходным кодом под лицензией MIT, что обеспечивает прозрачность и отсутствие привязки к конкретному поставщику.
Преимущества AnyCrawl
AnyCrawl - это высокопроизводительное веб-сканирующее решение, специально разработанное для приложений AI и LLM, обеспечивающее чистые структурированные данные с любого веб-сайта. Благодаря много-поточной архитектуре, оно обрабатывает страницы с исключительной скоростью, обрабатывая сайты с большим количеством JavaScript через интеграцию с движком Playwright. Дружественный к разработчикам API с полной документацией OpenAPI позволяет легко интегрироваться в приложения, а развертывание с нулевой конфигурацией через Docker делает его готовым к немедленному использованию. AnyCrawl предоставляет структурированные данные в форматах, оптимизированных для потребления AI, автоматическую очистку контента и надежность корпоративного уровня с поддержкой вращающихся прокси. Доступно как открытое программное обеспечение с гибкими тарифными планами, начиная с бесплатного уровня, оно пользуется доверием тысяч разработчиков для современных потребностей извлечения веб-данных.
Плюсы и минусы AnyCrawl
Преимущества
- LLM‑ready структурированные данные.
- Многопоточная высокая производительность.
- Открытый исходный код под MIT‑лицензией.
Недостатки
- Ограниченные бесплатные кредиты плана.
- Планируемые сканеры пока недоступны.
- Поддержка прокси всё ещё разрабатывается.
Основные возможности AnyCrawl
Извлечение веб-данных
Извлекает структурированные данные с веб-сайтов, преобразуя сырой HTML в чистые, организованные форматы, оптимизированные для использования ИИ и LLM.
Высокопроизводительный краулинг
Использует многопоточную архитектуру для невероятно быстрого краулинга, эффективно обрабатывая сложные веб-сайты и масштабную извлечение данных.
Выходные данные, готовые для LLM
Генерирует чистые, структурированные данные, специально отформатированные для больших языковых моделей, предоставляя готовые к использованию наборы данных для приложений машинного обучения.
Рендеринг JavaScript-контента
Обрабатывает сайты и SPAs с тяжелым использованием JavaScript с помощью движка Playwright, извлекая данные из современных веб-приложений с полной поддержкой рендеринга JavaScript.
API, удобное для разработчиков
Предоставляет всестороннюю спецификацию OpenAPI и RESTful-эндпоинты, позволяя бесшовно интегрировать возможности веб-краулинга в приложения.
Развертывание без настройки
Предлагает простое развертывание через Docker без необходимости конфигурации, поддерживает современные веб-фреймворки и обеспечивает мгновенную готовность службы.
Форматирование структурированных данных
Автоматически очищает и форматирует извлеченный контент в организованные структуры, делая данные сразу пригодными для последующей обработки и анализа.
Надежность корпоративного уровня
Обеспечивает производительность, готовую для продакшена, с надежной обработкой ошибок, ограничением скорости и возможностями мониторинга для критически важных приложений.
Открытый фреймворк
Полностью открытый исходный код с лицензией MIT, прозрачная разработка и вклад сообщества, что гарантирует отсутствие привязки к вендору и полный контроль над инфраструктурой.
Варианты использования AnyCrawl
- Ученые-аналитики данных: Извлечение структурированных веб-данных для обучения и анализа моделей ИИ с использованием готового к использованию с LLM вывода AnyCrawl.
- Аналитики электронной коммерции: Мониторинг цен конкурентов и информации о товарах на тысячах веб-страниц с использованием высокопроизводительного веб-краулинга.
- Исследователи контента: Сбор чистых, структурированных данных с множества веб-сайтов для агрегации контента и исследовательских целей.
- Разработчики: Интеграция веб-краулинговых возможностей в приложения с использованием комплексного API и спецификации OpenAPI от AnyCrawl.
- Специалисты по SEO: Извлечение и анализ данных SERP с поисковых систем для информирования стратегий SEO и отслеживания ранжирования ключевых слов.
Часто задаваемые вопросы AnyCrawl
Что такое AnyCrawl?
AnyCrawl — это кemplер на Node.js/TypeScript, предназначенный для преобразования веб-сайтов в чистые, структурированные данные, оптимизированные для AI-моделей и Large Language Models (LLM). Он предлагает такие функции, как веб-скрапинг в реальном времени, поддержка нескольких движков и высокопроизводительная обработка для извлечения значимого контента с любого веб-сайта.
Законно ли веб-скрапинг с помощью AnyCrawl?
Законность веб-скрапинга зависит от условий использования целевого веб-сайта и применимого законодательства. AnyCrawl предоставляет инструменты, но пользователи несут ответственность за обеспечение соответствия своей скрапинговой деятельности действующим нормам и политикам веб-сайтов.
Какие форматы данных поддерживает AnyCrawl?
AnyCrawl поддерживает несколько форматов данных, включая Markdown, JSON и структурированный HTML. Он может обрабатывать изображения, видео и другие медиафайлы, предоставляя чистый и организованный вывод, идеально подходящий для дальнейшей обработки и AI-приложений.
Может ли AnyCrawl обрабатывать сайты на JavaScript?
Да. AnyCrawl может обрабатывать сайты на JavaScript, используя движок Playwright. Он поддерживает одностраничные приложения (SPA) и динамическую загрузку контента, обеспечивая комплексное извлечение данных из современных веб-приложений.
Как устроено ценообразование?
AnyCrawl использует кредитную систему, где приблизительно 1 кредит равен 1 скрапленой странице/URL. Ценовые планы варьируются от бесплатного тарифа с 1500 кредитами в месяц до корпоративных планов с 100 000 кредитами и пользовательских решений для специфических требований.
Что считается одним кредитом?
Обычно кредит потребляется, когда AnyCrawl обрабатывает один URL или веб-страницу. Точное использование кредитов может варьироваться в зависимости от сложности страницы и конкретных функций, используемых при скрапинге.
Можно ли запланировать регулярные скрапинги?
Функция запланированных скрапингов скоро появится. В настоящее время пользователи могут вручную запускать скрапинги через API или панель управления, планируя ввести автоматическое планирование для задач регулярного извлечения данных.
Предоставляете ли вы поддержку прокси?
Да. AnyCrawl включает поддержку ротации прокси, чтобы помочь пользователям управлять IP-адресами и избегать ограничения скорости при скрапинге нескольких страниц или веб-сайтов. Эта функция доступна во всех платных тарифах.
Как использовать AnyCrawl
- Посетите веб-сайт AnyCrawl по адресу https://anycrawl.dev/ для изучения его функций и возможностей.
- Зарегистрируйтесь для получения бесплатной учетной записи, чтобы получить 1,500 кредитов и начать использовать веб-сканирование.
- Используйте предоставленный API для интеграции AnyCrawl в ваши приложения, обеспечивая бесперебойное извлечение веб-данных.
- Введите необходимые URL-адреса для сканирования и выберите соответствующий движок (например, auto) для оптимальных результатов.
- Просмотрите структурированный вывод данных, который отформатирован для использования в AI и LLM, обеспечивая чистую и организованную информацию.
AnyCrawl Анализ трафика сайта
Последняя информация о дорожном движении
- Ежемесячные посещения3.66K
- Показатель отказов33.2%
- Страниц за посещение2.09
- Продолжительность посещения00:00:36
- Глобальный рейтинг4.21M
- Рейтинг стран/регионов1.38M
Топ ключевых слов
| Ключевое слово | Трафик | Частотность | Частотность |
|---|---|---|---|
| free strong streaming platform template with integrated scraper | 110 | 120 | -- |
| anycrawl | 70 | 80 | -- |
| free twitter accoint scraper | 50 | 120 | -- |
| crawl ig photos | 50 | 90 | -- |
| tweet scraper no login | 50 | 90 | -- |
Лучшие регионы
| Область | Процент |
|---|---|
| Соединенные Штаты | 96.94% |
| Индия | 3.06% |
AnyCrawl Альтернативы
Читайте все публичные комментарии и ответы к постам TikTok, Instagram и YouTube без входа в аккаунт и экспортируйте ветку в CSV или Excel, когда нужны сами строки.
Просматривайте публичные истории, видео, комментарии и аватарки TikTok по имени пользователя без входа в аккаунт и без приложения. Скачивание по одному бесплатно, пакетные задачи — за кредиты.
ZocialComment экспортирует комментарии из TikTok, Instagram, YouTube, Reddit, Facebook и Threads в CSV или JSON с AI-анализом. Регистрация не требуется.
AI-клонер сайтов, который восстанавливает живые сайты по URL в редактируемый код React + Tailwind. Бесплатный предпросмотр, клоны из нескольких страниц, экспорт готового кода без подписки.
EnsembleData предоставляет API для парсинга социальных сетей в реальном времени, включая TikTok, Instagram, YouTube и другие. Извлекайте посты, профили и аналитику в любом масштабе.
KeyAPI — это AI‑готовая платформа единого API для социальных сетей, дающая разработчикам, создателям ИИ и инженерам автоматизации единый доступ к более чем 20‑м сетям, к данным в реальном времени и историческим, с задержкой менее 500 мс и автоматически масштабируемой инфраструктурой.
Поиск профилей в социальных сетях — это онлайн‑инструмент для поиска пользовательских имён, который в реальном времени сканирует более 400 социальных сетей, помогая рекрутерам, следователям, маркетологам и другим быстро находить и экспортировать аккаунты.

Changeflow использует ИИ для мониторинга веб-сайтов бизнеса, предоставляя оповещения об изменениях в регулировании, конкурентах и соблюдении нормативных требований с обобщенными аналитическими данными.
LinkFinder AI мгновенно обогащает данные о лидах и компаниях, находя веб-сайты, электронные письма, номера телефонов и информацию LinkedIn из различных источников.
Это корпоративный API-сервис веб-скрейпинга предоставляет извлечение контента с поддержкой JSON и HTML, глобальное ускорение CDN и интеллектуальное кеширование для эффективного получения данных.
Этот инструмент извлекает комментарии к видео TikTok в CSV или Excel для анализа, помогая маркетологам и создателям экономить время на проверке отзывов и отчетах о кампаниях, с возможностью анонимного просмотра.
Этот бесплатный онлайн-инструмент позволяет пользователям скачивать моды, карты и контент Steam Workshop для более чем 1000 игр, включая CS2 и Skyrim, без необходимости установки клиента Steam или регистрации.