

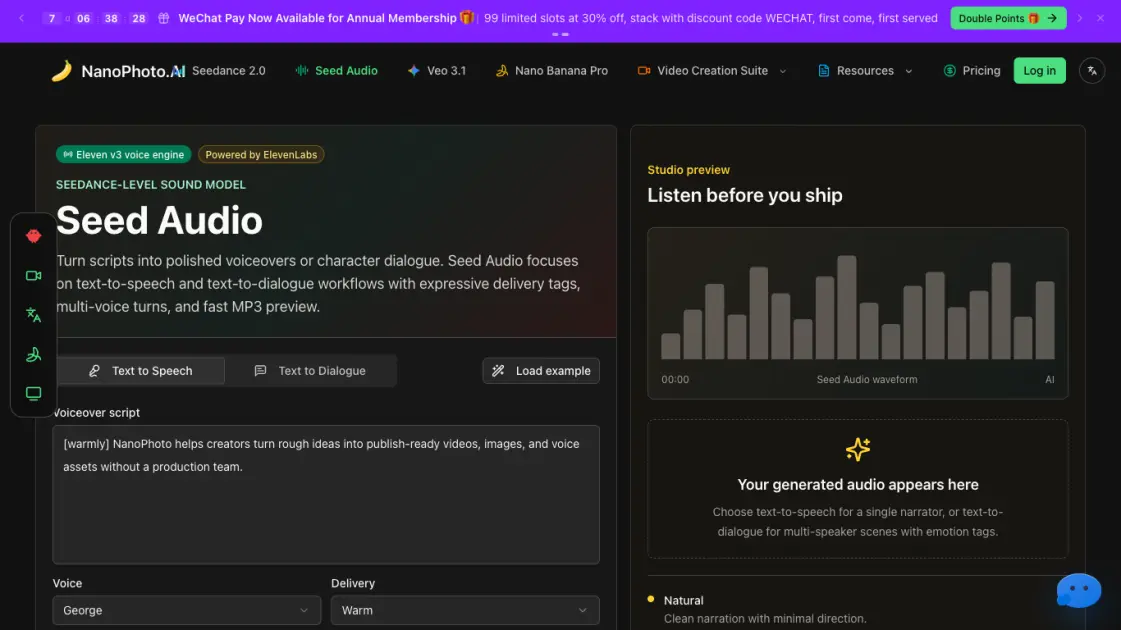
Seed Audio이(가) 무엇인가요?
Seed Audio는 ElevenLabs 인프라 위에 구축된 텍스트 음성 변환 및 대화 생성 도구로, NanoPhoto 플랫폼을 통해 사용할 수 있습니다. 이 서비스는 작성된 스크립트를 MP3 오디오로 변환하며, 단일 음성 내레이션과 음성 할당이 가능한 다중 화자 대화의 두 가지 주요 모드를 제공합니다.
laughing, whispering, sighs, [short pause](짧은 멈춤) 같은 퍼포먼스 태그를 통해 전달 스타일을 세밀하게 제어할 수 있습니다. Natural(내추럴), Warm(웜), Cinematic(시네마틱)의 세 가지 프리셋 방향은 설명 영상, 트레일러, 온보딩 자료 등 다양한 콘텐츠 유형에 맞게 속도와 톤을 조정합니다.
워크플로는 작성-지시-렌더링-듣기-다운로드 루프로 진행되며, 내보내기 전 브라우저에서 MP3를 미리 들을 수 있습니다. 출력물은 영상 편집, 팟캐스트 초안, 광고 목업, 제품 데모 등에 활용됩니다.
Seed Audio는 어떻게 작동하나요?
Seed Audio는 ElevenLabs의 텍스트 음성 변환 및 텍스트 대화 변환 모델을 기반으로 하는 간소화된 4단계 워크플로를 통해 작동합니다. 사용자는 먼저 소스 스크립트를 작성합니다. 단일 내레이션 문단이거나, 여러 화자가 등장하는 장면을 위한 2~4턴의 대화 형식입니다. 다음으로 음성을 선택합니다. 텍스트 음성 변환 모드에서는 한 명의 내레이터를, 대화 모드에서는 각 턴에 서로 다른 캐릭터 음성을 할당합니다.[warmly](따뜻하게)、[curious](호기심을 담아)、[laughing](웃으며)、[whispering](속삭이며)、[sighs](한숨)、[short pause](잠시 멈춤)같은 연기 태그가 감정 표현과 속도를 제어합니다. 마지막으로 시스템이 브라우저에서 재생 가능한 MP3 미리보기를 생성하여, 다운로드 전에 즉시 들어볼 수 있습니다. 영상 편집, 팟캐스트 초안, 광고 목업, 제품 데모 등에 활용할 수 있습니다.
Seed Audio의 이점
Seed Audio는 텍스트 음성 변환 및 다중 화자 대화 생성을 ElevenLabs 기반의 단일 브라우저 도구로 통합하여 개별 편집기 간 전환할 필요를 없앱니다. [laughing], [whispering], [sighs], [short pause]와 같은 퍼포먼스 태그는 Natural, Warm, Cinematic 세 가지 전달 스타일에서 세밀한 감정 제어를 제공하며, 턴별 음성 할당 기능을 통해 팟캐스트, 게임 프로토타입, 스토리보드 데모에서 설득력 있는 캐릭터 대화를 구현할 수 있습니다. 긴밀한 작성-지시-렌더링-듣기-다운로드 루프는 수 초 안에 게시 가능한 MP3를 생성하지만, 워크플로는 ElevenLabs의 음성 라이브러리로 제한되어 커스텀 음성 트레이닝, API 액세스 또는 배치 처리를 지원하지 않으며, 연간 668달러의 가격대는 가벼운 실험 용도로는 부담스러운 수준입니다.
Seed Audio의 장점과 단점
장점
- TTS(텍스트 음성 변환)와 대화 생성을 하나의 도구에 통합
- 성능 태그로 감정과 전달 방식 제어
- 여러 음성의 대화 장면과 발언 할당 지원
- 브라우저에서 빠른 MP3 미리듣기 및 다운로드
- 세 가지 전달 스타일: Natural, Warm, Cinematic
단점
- ElevenLabs 계정 필요
- 크레딧 기반 가격 모델로 사용량 제한
- 오디오 전용 출력, 비디오 동기화 미지원
- 맞춤형 음성 복제 기능 언급 없음
- 웹 기반 전용, 오프라인 기능 없음
Seed Audio의 핵심 기능
텍스트 음성 변환 생성
스크립트, 훅, 설명문, 짧은 광고 내레이션을 깔끔하고 자연스러운 단일 내레이터 음성으로 생성합니다.
텍스트 대화 생성
데모, 팟캐스트, 게임, 스토리보드를 위해 각 턴에 다른 음성을 할당하여 여러 화자의 대화를 만듭니다.
표현 태그
[laughing] 웃음, [whispering] 속삭임, [sighs] 한숨, [short pause] 짧은 멈춤과 같은 인라인 태그를 사용하여 표현력 있는 음성 전달을 제어합니다.
전달 스타일 프리셋
Natural(자연스러움)은 깔끔한 내레이션, Warm(따뜻함)은 친근한 설명, Cinematic(영화적)은 극적인 템포의 세 가지 프리셋 스타일을 제공합니다.
턴별 음성 선택
대화의 각 턴에 개별 음성을 할당하여 여러 화자 장면에서 설득력 있는 캐릭터 교환을 가능하게 합니다.
MP3 미리보기 및 다운로드
오디오를 MP3로 렌더링하여 브라우저에서 재생하고, 비디오 편집, 팟캐스트 초안, 데모용 다운로드 파일을 제공합니다.
Seed Audio의 사용 사례
- 콘텐츠 크리에이터: 표현력 있는 전달 태그를 사용하여 비디오 편집, 예고편, 스토리보드용 보이스오버 생성
- 팟캐스터: 멀티 보이스 대화 생성을 사용하여 팟캐스트 초안과 다중 화자 대화 에피소드 제작
- 광고주: 따뜻한, 영화적, 또는 자연스러운 전달 스타일로 광고 모크업과 제품 데모 보이스오버 제작
- 게임 개발자: 게임 프로토타입과 스토리보드용 캐릭터 대사와 내레이션 보이스오버 생성
- 비디오 편집자: 러프 컷, 클라이언트 리뷰, 최종 비디오 내보내기용 빠른 보이스오버 초안 제작
Seed Audio의 FAQ
Seed Audio란 무엇인가요?
Seed Audio는 ElevenLabs 기술을 기반으로 NanoPhoto 플랫폼에 통합된 AI 기반 텍스트 음성 변환(Text-to-Speech) 및 텍스트 대화 생성 도구입니다. 작성된 스크립트를 표현력 있는 연기 태그, 다중 음성 대화 지원, 빠른 MP3 미리보기와 함께 음성 오디오로 변환합니다. 사용자는 스크립트를 작성하거나 붙여넣고, 음성을 선택하고, 필요에 따라 전달 방향을 추가한 후 브라우저를 떠나지 않고 몇 초 만에 들을 수 있는 오디오를 생성할 수 있습니다.
텍스트 음성 변환과 텍스트 대화 생성의 차이점은 무엇인가요?
텍스트 음성 변환(TTS)은 텍스트 블록에서 단일 내레이터의 음성 해설을 생성하며, 설명 영상, 광고 낭독, 음성 초안에 적합합니다. 텍스트 대화 생성은 스크립트의 개별 발화에 서로 다른 음성을 할당하여 팟캐스트, 게임 대사, 데모, 스토리보드를 위한 다중 화자 대화를 지원합니다. 대화 모드는 또한 발화별 연기 태그를 지원하여 각 캐릭터의 전달을 독립적으로 연출할 수 있습니다.
어떤 연기 태그가 지원되나요?
Seed Audio는 [laughing], [whispering], [sighs], [short pause], [warmly], [curious] 등과 같은 태그를 인식하여 출력의 감정적 톤과 템포를 조절합니다. 이러한 태그는 전달 방식이 변경되어야 하는 지점의 스크립트 텍스트에 직접 삽입됩니다. TTS 모드와 대화 모드 모두에서 작동하며, 사용자는 외부 오디오 편집 없이도 특정 대사의 느낌을 세밀하게 제어할 수 있습니다.
Seed Audio의 가격 체계는 어떻게 되나요?
Seed Audio는 크레딧 기반 가격 모델을 사용하며, 각 오디오 생성에 1크레딧이 소모됩니다. 크레딧은 NanoPhoto 플랫폼을 통해 구매하며 제품군 전체에서 사용할 수 있습니다. 이 사용량 기반 모델은 작업량이 변동하는 사용자에게 적합하며, 월간 구독 약정 없이 가끔의 음성 초안부터 대량의 대화 제작까지 유연하게 대응할 수 있습니다.
Seed Audio는 누구를 위해 설계되었나요?
Seed Audio는 빠르게 사용 가능한 음성 에셋이 필요한 콘텐츠 제작자, 비디오 편집자, 팟캐스터, 게임 개발자, 제품 팀을 대상으로 합니다. 광고 목업, 튜토리얼 음성 해설, 인디 게임의 캐릭터 대화, 팟캐스트 초안 녹음 등 속도가 중요한 작업 흐름에 적합합니다. 매번 짧은 스크립트마다 전문 오디오 스튜디오를 열어야 했던 사용자도 동일한 작업을 훨씬 짧은 시간 안에 완료할 수 있습니다.
Seed Audio는 어떤 오디오 형식을 출력하나요?
Seed Audio는 MP3 파일을 생성하며, 브라우저에서 직접 미리 듣고 비디오 편집 소프트웨어, 팟캐스트 제작 도구, 게임 엔진, 프레젠테이션 자료에 다운로드하여 사용할 수 있습니다. MP3는 파일 크기와 오디오 품질의 균형이 좋아 빠른 초안과 최종 에셋 모두에 실용적인 출력 형식으로 선택되었습니다.
Seed Audio는 독립형 TTS 도구와 어떻게 다른가요?
스크립트 편집, 음성 선택, 오디오 내보내기를 위해 앱을 전환해야 하는 독립형 TTS 도구와 달리, Seed Audio는 전체 작업 흐름을 NanoPhoto 플랫폼 내에서 유지합니다. 사용자는 하나의 인터페이스에서 작성, 연출, 렌더링, 듣기, 다운로드를 모두 수행합니다. 내장된 연기 태그 시스템과 다중 화자 대화 모드는 기본적인 전달 조정을 위한 별도의 오디오 편집 과정을 제거하여, 반복 시간을 분 단위에서 초 단위로 단축합니다.
Seed Audio 사용 방법
- 내레이션 단락을 입력하거나 2~4 턴의 대화(자연스러운 발화에 초점을 맞춘 4턴 대화)를 작성하여 소스 스크립트를 구성합니다.
- 내레이터 음성을 선택하여 텍스트 음성 변환(TTS)을 하거나, 각 대화 턴에 다른 음성을 할당하여 캐릭터 간 교환을 구현합니다.
- [warmly], [curious], [laughing], [short pause] 같은 퍼포먼스 태그를 추가하여 감정 표현을 유도하고 마치 연출된 듯한 결과물을 얻을 수 있습니다.
- 브라우저에서 생성된 MP3를 미리 듣고 품질을 확인한 후, 오디오 파일을 다운로드하여 비디오 편집, 팟캐스트 초안, 광고 목업, 제품 데모에 사용합니다.
Seed Audio 웹사이트 트래픽 분석
최신 교통정보
- 월간 방문127.48K
- 반송률40.7%
- 방문당 페이지 수1.76
- 방문 기간00:00:37
- 세계 순위340.66K
- 국가/지역 순위33.75K
인기 키워드
| 예어 | 트래픽 | 인기 | 클릭당 비용 |
|---|---|---|---|
| nano banana | 380 | 1.64M | $0.7 |
| 视频提示词反推 | 320 | 310 | -- |
| nano photo ai | 240 | 240 | -- |
| subtitle remover | 230 | 2.2K | $0.2 |
| nanophoto ai | 230 | 490 | -- |
상위 지역
| 지역 | 백분율 |
|---|---|
| 중국 | 49.75% |
| 미국 | 4.69% |
| 말레이시아 | 3.47% |
| 대만 | 3.14% |
| 인도 | 2.22% |
Seed Audio 대안
MixVio는 브라우저 워크스페이스에서 21개의 영상·이미지·오디오 모델을 실행하고 창작자 도구 11종을 제공하며, 생성 전에 정확한 크레딧 비용을 표시합니다.
PodcastorAI는 PDF, URL, 노트, 오디오를 YouTube, Spotify, TikTok용 스튜디오급 영상 팟캐스트로 전환하며, AI 호스트, AI 음성, 스크립트 생성을 지원합니다.
Miso One AI는 크리에이터와 개발 팀이 표현력 있는 대화 음성을 제작하고, 클론 테스트, 프롬프트 검토, 크레딧 추적을 통해 음성 샘플을 다운로드할 수 있는 AI 보이스 제너레이터입니다.

Petti Chat은 AI 기반 웹 도구로, 반려동물의 짧은 소리를 캡처하고 그 의도를 인간 언어로 해석한 뒤 차분하고 반려동물 친화적인 오디오로 답변합니다. 개인정보를 보호하면서 실시간 상호작용이 가능합니다.
GPT Realtime 2는 개발자와 제품 팀을 위한 AI 음성 생성기로, 실시간 음성-음성 상호작용, 저지연 오디오, 프롬프트 제어, 도구 연계 및 세션 녹음 다운로드 기능을 제공합니다.
GPT Realtime는 개발자와 제품 팀을 위한 AI 음성 생성 플랫폼으로, 저지연 음성‑음성 변환, 이미지 인식 프롬프트, SIP 통화 지원, API 워크플로우 설계 및 재사용 가능한 캐시를 제공해 빠른 음성 앱 프로토타이핑을 가능하게 합니다.
이 온라인 PDF 음성 리더는 OCR을 통해 스캔된 파일 포함 문서를 142개 이상의 언어로 자연스러운 음성으로 변환하고 모든 PDF 형식을 지원합니다.
AnySpeech는 50개 이상의 언어로 100가지 이상의 사실적인 음성을 제공하는 전문 AI 텍스트 음성 변환 플랫폼으로, 전 세계의 콘텐츠 제작자, YouTuber, 팟캐스터를 위해 설계되었습니다.