
Seed Audio
Seed Audio - Alat AI Teks ke Ucapan dan Pembuatan Dialog

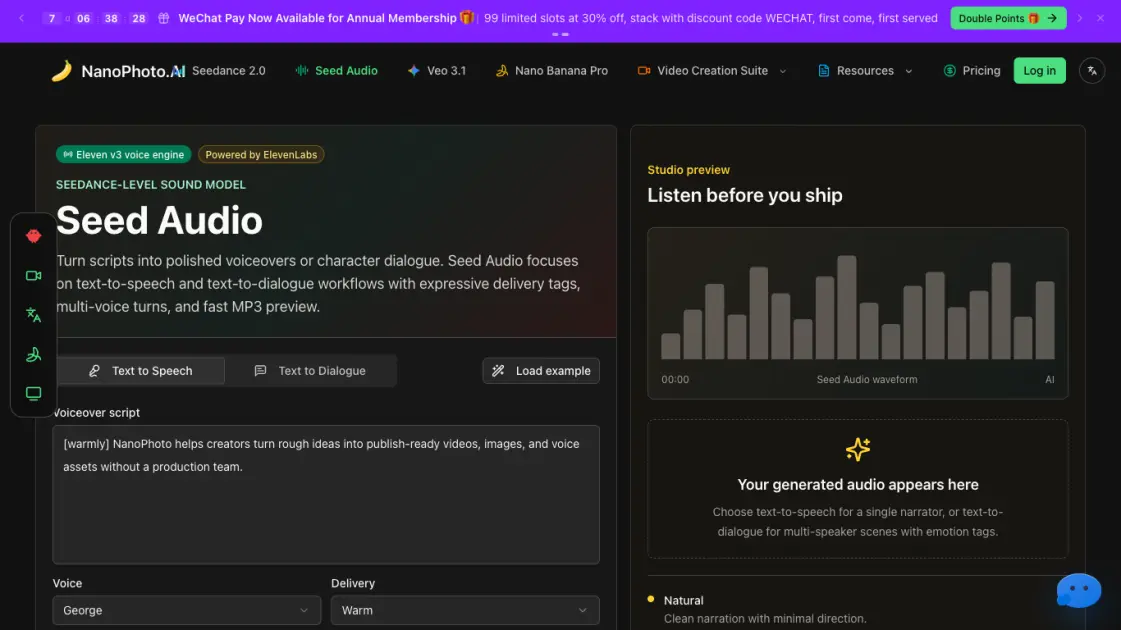
Apa itu Seed Audio
Seed Audio adalah alat text-to-speech dan pembuatan dialog yang dibangun di atas infrastruktur ElevenLabs, dapat diakses melalui platform NanoPhoto. Layanan ini mengonversi naskah tertulis menjadi audio MP3 dengan dua mode utama: narasi satu suara dan dialog multi-pembicara dengan penugasan giliran bicara.
Tag performa seperti [laughing] (tertawa), [whispering] (berbisik), [sighs] (menghela napas), dan [short pause] (jeda singkat) memberikan kendali detail atas gaya penyampaian. Tiga arah prasetel — Natural (natural), Warm (hangat), dan Cinematic (sinematik) — menyesuaikan tempo dan nada untuk berbagai jenis konten termasuk video penjelasan, trailer, dan materi orientasi.
Alur kerja mengikuti siklus tulis-arahkan-render-dengar-unduh dengan pratinjau MP3 di browser sebelum ekspor. Outputnya digunakan untuk penyuntingan video, draf podcast, mockup iklan, dan demo produk.
Bagaimana cara Seed Audio bekerja
Seed Audio beroperasi melalui alur kerja empat langkah yang efisien, didukung oleh model teks-ke-ucapan (text-to-speech) dan teks-ke-dialog (text-to-dialogue) dari ElevenLabs. Pengguna memulai dengan menulis naskah sumber — baik satu paragraf narasi atau dua hingga empat giliran dialog untuk adegan dengan banyak pembicara. Selanjutnya, mereka memilih suara: satu narator untuk mode teks-ke-ucapan, atau menetapkan suara berbeda untuk setiap giliran dialog dalam percakapan berbasis karakter. Tag performa seperti [warmly](dengan hangat)、[curious](dengan penasaran)、[laughing](tertawa)、[whispering](berbisik)、[sighs](menghela napas)、dan [short pause](jeda singkat)mengarahkan penyampaian emosi dan kecepatan bicara. Terakhir, sistem menghasilkan pratinjau MP3 yang dapat diputar di browser, memungkinkan pendengaran langsung sebelum diunduh untuk suntingan video, draf podcast, purwarupa iklan, atau demo produk.
Manfaat Seed Audio
Seed Audio menggabungkan sintesis teks-ke-ucapan dan pembuatan dialog multi-pembicara ke dalam satu alat peramban yang didukung oleh ElevenLabs, menghilangkan kebutuhan untuk berpindah antar editor terpisah. Tag performa seperti [laughing], [whispering], [sighs], dan [short pause] memberikan kontrol emosi yang terperinci dalam gaya penyampaian Natural, Warm, dan Cinematic, sementara penugasan suara per giliran memungkinkan pertukaran karakter yang meyakinkan untuk podcast, prototipe game, dan demo papan cerita. Siklus tulis-arahkan-render-dengar-unduh yang ketat menghasilkan MP3 siap terbit dalam hitungan detik, meskipun alur kerja tetap terbatas pada pustaka suara ElevenLabs tanpa pelatihan suara kustom, akses API, atau pemrosesan batch, dan harga tahunan sebesar 668 dolar AS berada di luar jangkauan eksperimen kasual.
Kelebihan dan Kekurangan Seed Audio
Kelebihan
- Menggabungkan TTS (text-to-speech) dan generasi dialog dalam satu alat
- Tag performa mengontrol emosi dan cara penyampaian
- Adegan dialog multi-suara dengan penugasan giliran bicara
- Pratinjau MP3 cepat dan unduhan di browser
- Tiga gaya penyampaian: Natural, Warm, Cinematic
Kekurangan
- Memerlukan akun ElevenLabs untuk generasi
- Model harga berbasis kredit membatasi penggunaan
- Output hanya audio, tanpa sinkronisasi video
- Tidak disebutkan kloning suara kustom
- Hanya berbasis web, tanpa kemampuan offline
Fitur Inti Seed Audio
Pembuatan Teks ke Suara
Menghasilkan sulih suara narator tunggal dari naskah, hook, penjelasan, dan pembacaan iklan pendek dengan penyampaian yang bersih dan alami.
Pembuatan Teks ke Dialog
Membuat percakapan multi-pembicara dengan menetapkan suara yang berbeda untuk setiap giliran untuk demo, podcast, game, dan papan cerita.
Tag Performa
Mengontrol penyampaian vokal menggunakan tag inline seperti [laughing] (tertawa), [whispering] (berbisik), [sighs] (menghela napas), dan [short pause] (jeda singkat) untuk kontrol ekspresif.
Prasetel Gaya Penyampaian
Menawarkan tiga gaya prasetel: Natural untuk narasi bersih, Warm untuk penjelasan ramah, Cinematic untuk tempo dramatis.
Pemilihan Suara per Giliran
Memungkinkan penetapan suara individu per giliran dialog, memungkinkan pertukaran karakter yang meyakinkan dalam adegan multi-pembicara.
Pratinjau dan Unduh MP3
Merender audio ke MP3 dengan pemutaran di dalam browser, lalu menyediakan file yang dapat diunduh untuk suntingan video, draf podcast, dan demo.
Kasus Penggunaan Seed Audio
- Kreator konten: Hasilkan voiceover untuk edit video, trailer, dan storyboard dengan tag pengiriman ekspresif
- Podcaster: Produksi draf podcast dan episode dialog multi-pembicara menggunakan generasi dialog multi-suara
- Pengiklan: Buat mockup iklan dan voiceover demo produk dengan gaya pengiriman hangat, sinematik, atau alami
- Pengembang game: Hasilkan dialog karakter dan voiceover naratif untuk prototipe game dan storyboard
- Editor video: Produksi draf voiceover cepat untuk rough cut, review klien, dan ekspor video final
FAQ dari Seed Audio
Apa itu Seed Audio?
Seed Audio adalah alat text-to-speech (TTS) dan text-to-dialogue berbasis AI yang dibangun di atas teknologi ElevenLabs dan terintegrasi ke dalam platform NanoPhoto. Alat ini mengubah naskah tertulis menjadi audio yang diucapkan dengan tag performa ekspresif, dukungan dialog multi-suara, dan pratinjau MP3 cepat. Pengguna menulis atau menempelkan naskah, memilih suara, secara opsional menambahkan arahan penyampaian, dan menghasilkan audio yang dapat didengar dalam hitungan detik tanpa meninggalkan browser.
Apa perbedaan antara text-to-speech dan text-to-dialogue?
Text-to-speech (TTS) menghasilkan sulih suara narator tunggal dari blok teks, ideal untuk video penjelasan, pembacaan iklan, dan draf sulih suara. Text-to-dialogue memberikan suara yang berbeda untuk setiap giliran bicara dalam naskah, mendukung percakapan multi-pembicara untuk podcast, dialog game, demo, dan papan cerita. Mode dialog juga menerima tag performa per giliran bicara sehingga penyampaian setiap karakter dapat diarahkan secara independen.
Tag performa apa saja yang didukung?
Seed Audio mengenali tag seperti [laughing], [whispering], [sighs], [short pause], [warmly], [curious], dan lainnya yang mengarahkan suasana emosional dan tempo keluaran. Tag-tag ini disisipkan langsung ke dalam teks naskah pada titik di mana penyampaian harus berubah. Tag ini berfungsi baik dalam mode TTS maupun dialog, memberikan pengguna kendali yang terperinci atas bagaimana suatu kalimat terdengar tanpa perlu penyuntingan audio eksternal.
Bagaimana cara kerja harga Seed Audio?
Seed Audio menggunakan model harga berbasis kredit, di mana setiap generasi audio membutuhkan biaya 1 kredit. Kredit dibeli melalui platform NanoPhoto dan berlaku di seluruh rangkaian produk. Model bayar-per-generasi ini cocok untuk pengguna dengan beban kerja yang bervariasi, dari draf sulih suara sesekali hingga produksi dialog bervolume tinggi, tanpa memerlukan komitmen langganan bulanan.
Untuk siapa Seed Audio dirancang?
Seed Audio ditujukan untuk pembuat konten, editor video, podcaster, pengembang game, dan tim produk yang membutuhkan aset suara yang cepat dan siap publikasi. Alat ini cocok untuk alur kerja yang mengutamakan kecepatan, seperti purwarupa iklan, sulih suara tutorial, dialog karakter untuk game indie, dan rekaman draf podcast. Pengguna yang biasanya harus membuka studio audio khusus untuk setiap naskah pendek dapat menyelesaikan tugas yang sama dalam waktu yang jauh lebih singkat.
Format audio apa yang dihasilkan Seed Audio?
Seed Audio menghasilkan file MP3 yang dapat dipratinjau langsung di browser dan diunduh untuk digunakan di perangkat lunak penyuntingan video, alat produksi podcast, mesin game, dan slide presentasi. MP3 dipilih sebagai format keluaran karena keseimbangan antara ukuran file dan kualitas audio, menjadikannya praktis baik untuk draf cepat maupun aset final.
Bagaimana perbandingan Seed Audio dengan alat TTS mandiri?
Tidak seperti alat TTS mandiri yang memerlukan perpindahan antar aplikasi untuk penyuntingan naskah, pemilihan suara, dan ekspor audio, Seed Audio menjaga seluruh alur kerja di dalam platform NanoPhoto. Pengguna menulis, mengarahkan, merender, mendengarkan, dan mengunduh dalam satu antarmuka. Sistem tag performa bawaan dan mode dialog multi-pembicara menghilangkan kebutuhan akan sesi penyuntingan audio terpisah untuk penyesuaian penyampaian dasar, mengurangi waktu iterasi dari menit menjadi detik per generasi.
Cara menggunakan Seed Audio
- Tulis skrip sumber dengan memasukkan paragraf sulih suara atau dua hingga empat giliran dialog, atau empat giliran dialog yang berfokus pada ucapan yang terdengar alami.
- Pilih suara dan penyampaian dengan memilih suara narator untuk text-to-speech (TTS) atau menetapkan suara berbeda untuk setiap giliran dialog demi pertukaran karakter.
- Tambahkan tag performa seperti [warmly] (dengan hangat), [curious] (penasaran), [laughing] (tertawa), atau [short pause] (jeda singkat) untuk memandu penyampaian emosional dan membuat hasilnya terasa terarah.
- Pratinjau MP3 yang dihasilkan di browser untuk memverifikasi kualitas, lalu unduh file audio untuk suntingan video, draf podcast, purwarupa iklan, atau demo produk.
Seed Audio Analisis Lalu Lintas Situs Web
Informasi lalu lintas terkini
- Kunjungan Bulanan127.48K
- Rasio Pentalan40.7%
- Halaman Per Kunjungan1.76
- Durasi Kunjungan00:00:37
- Peringkat global340.66K
- Peringkat Negara/Wilayah33.75K
Kata Kunci Teratas
| Kata kunci | Lalulintas | Volume | Biaya Per Klik |
|---|---|---|---|
| nano banana | 380 | 1.64M | $0.7 |
| 视频提示词反推 | 320 | 310 | -- |
| nano photo ai | 240 | 240 | -- |
| subtitle remover | 230 | 2.2K | $0.2 |
| nanophoto ai | 230 | 490 | -- |
Wilayah Teratas
| Wilayah | Persentase |
|---|---|
| Tiongkok | 49.75% |
| Amerika Serikat | 4.69% |
| Malaysia | 3.47% |
| Taiwan | 3.14% |
| India | 2.22% |
Seed Audio Alternatif
LOVO AI mengubah naskah menjadi narasi MP3 langsung di peramban, dengan 21 pratinjau suara, kloning suara berbasis izin, sintesis 74 bahasa, dan editor video.

Play HT adalah generator suara AI gratis yang mengubah teks menjadi ucapan, dengan 200+ suara publik, pratinjau langsung di browser, dan ekspor berkas MP3.
MixVio menjalankan 21 model video, gambar, dan audio di satu ruang kerja browser, menyediakan 11 alat untuk kreator, dan menampilkan biaya kredit yang tepat sebelum setiap pembuatan.
PodcastorAI mengubah PDF, URL, catatan, dan audio menjadi video podcast berkualitas studio untuk YouTube, Spotify, dan TikTok, lengkap dengan host AI, suara, dan skrip.
KidVoice adalah pembuat suara anak AI yang menghasilkan suara alami anak dan remaja dari teks, dengan dukungan multibahasa dan kloning suara.
Miso One AI adalah generator suara AI yang memungkinkan kreator dan tim pengembang menghasilkan audio dialog yang ekspresif, menguji kloning, meninjau prompt, serta mengunduh sampel suara dengan pelacakan kredit.
Petti Chat adalah alat web berbasis AI yang memungkinkan pemilik hewan peliharaan merekam suara singkat hewan, menafsirkan kemungkinan maksudnya dalam bahasa manusia, dan membalas dengan audio yang tenang serta ramah hewan, menjamin privasi dan interaksi waktu nyata.
GPT Realtime 2 adalah generator suara AI untuk pengembang dan tim produk, menyediakan interaksi suara‑ke‑suara secara real‑time, audio berlatensi rendah, kontrol prompt, alih alat, serta rekaman sesi yang dapat diunduh.
GPT Realtime adalah platform generator suara AI untuk pengembang dan tim produk, menyediakan speech‑to‑speech dengan latensi rendah, prompt yang mendukung gambar, dukungan panggilan SIP, perencanaan alur kerja API, serta cache dapat dipakai ulang untuk prototipe aplikasi suara secara cepat.
Pembaca PDF online dengan suara ini menggunakan AI untuk mengonversi dokumen, termasuk file yang dipindai melalui OCR, menjadi ucapan alami dalam 142+ bahasa, mendukung semua format PDF.
AnySpeech adalah platform profesional teks ke suara AI yang menawarkan 100+ suara realistis dalam 50+ bahasa, dirancang untuk kreator konten, YouTuber, dan podcaster di seluruh dunia.
FineVoice AI Voice Generator memungkinkan kreator mengubah teks menjadi ucapan dengan suara AI yang realistis dan mengkloning suara dalam gaya atau bahasa apa pun dengan mudah.