
Seed Audio - Outil IA de synthèse vocale et génération de dialogues

Qu'est-ce que Seed Audio
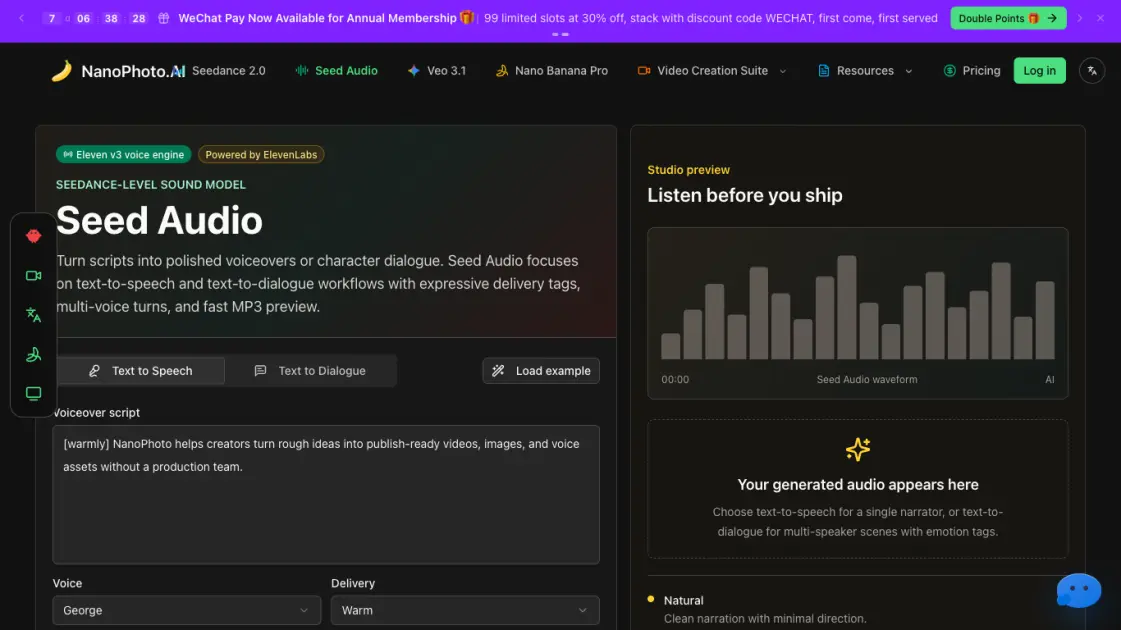
Seed Audio est un outil de synthèse vocale et de génération de dialogues construit sur l'infrastructure d'ElevenLabs, accessible via la plateforme NanoPhoto. Le service convertit des scripts écrits en audio MP3 selon deux modes principaux : la narration à une seule voix et le dialogue à plusieurs intervenants avec répartition des tours de parole.
Des balises de performance telles que [laughing] (rire), [whispering] (chuchotement), [sighs] (soupirs) et [short pause] (courte pause) offrent un contrôle précis du style d'interprétation. Trois directions prédéfinies — Natural (naturel), Warm (chaleureux) et Cinematic (cinématographique) — ajustent le rythme et le ton pour différents types de contenu, notamment les vidéos explicatives, les bandes-annonces et les supports d'intégration.
Le flux de travail suit une boucle « écrire-diriger-rendre-écouter-télécharger » avec un aperçu MP3 dans le navigateur avant l'exportation. Les résultats sont utilisés pour le montage vidéo, les brouillons de podcasts, les maquettes publicitaires et les démonstrations de produits.
Comment fonctionne Seed Audio
Seed Audio fonctionne via un flux de travail simplifié en quatre étapes, propulsé par les modèles de synthèse vocale (text-to-speech) et de texte en dialogue (text-to-dialogue) d'ElevenLabs. Les utilisateurs commencent par rédiger un script source — un seul paragraphe de voix off ou deux à quatre tours de dialogue pour des scènes à plusieurs intervenants. Ensuite, ils sélectionnent les voix : un seul narrateur pour le mode synthèse vocale, ou des voix distinctes pour chaque tour de dialogue dans les conversations scénarisées. Les balises d'interprétation telles que [warmly](avec chaleur)、[curious](avec curiosité)、[laughing](en riant)、[whispering](en murmurant)、[sighs](en soupirant)et [short pause](pause courte)orientent l'expression émotionnelle et le rythme. Enfin, le système génère un aperçu MP3 lisible dans le navigateur, permettant une écoute immédiate avant le téléchargement pour le montage vidéo, les brouillons de podcast, les maquettes publicitaires ou les démonstrations de produits.
Avantages de Seed Audio
Seed Audio regroupe la synthèse vocale et la génération de dialogues multi-locuteurs dans un seul outil navigateur propulsé par ElevenLabs, éliminant le besoin de basculer entre plusieurs éditeurs. Les balises de performance telles que [laughing], [whispering], [sighs] et [short pause] offrent un contrôle émotionnel granulaire dans les styles de diction Natural, Warm et Cinematic, tandis que l'attribution vocale par tour permet des échanges crédibles entre personnages pour les podcasts, les prototypes de jeux et les démos de storyboard. La boucle serrée écriture-mise en scène-rendu-écoute-téléchargement produit des MP3 publiable en quelques secondes, bien que le flux de travail reste limité à la bibliothèque vocale d'ElevenLabs sans entraînement vocal personnalisé, accès API ni traitement par lots, et le prix annuel de 668 dollars se situe au-dessus d'une expérimentation occasionnelle.
Avantages et inconvénients de Seed Audio
Avantages
- Combine TTS (synthèse vocale) et génération de dialogues dans un seul outil
- Les balises de performance contrôlent l'émotion et le débit
- Scènes de dialogue multi-voix avec attribution des tours de parole
- Aperçu MP3 rapide et téléchargement dans le navigateur
- Trois styles de délivrance : Natural, Warm, Cinematic
Inconvénients
- Nécessite un compte ElevenLabs pour la génération
- Le modèle de crédits limite l'utilisation
- Sortie audio uniquement, sans synchronisation vidéo
- Aucun clonage vocal personnalisé mentionné
- Uniquement en ligne, pas de capacité hors ligne
Fonctionnalités principales de Seed Audio
Génération de synthèse vocale
Produit des voix off à un seul narrateur à partir de scripts, d'accroches, d'explications et de courtes lectures publicitaires avec un rendu clair et naturel.
Génération de dialogues à partir de texte
Crée des conversations à plusieurs intervenants en attribuant des voix distinctes à chaque tour pour les démos, podcasts, jeux et storyboards.
Balises de performance
Oriente le rendu vocal à l'aide de balises en ligne telles que [laughing] (rire), [whispering] (murmure), [sighs] (soupir) et [short pause] (courte pause) pour un contrôle expressif.
Préréglages de style de rendu
Propose trois styles prédéfinis : Natural pour une narration claire, Warm pour des explications amicales, Cinematic pour un rythme dramatique.
Sélection vocale par tour
Permet d'attribuer une voix individuelle à chaque tour de dialogue, offrant des échanges crédibles entre personnages dans les scènes à plusieurs intervenants.
Aperçu et téléchargement MP3
Convertit l'audio en MP3 avec lecture dans le navigateur, puis fournit des fichiers téléchargeables pour le montage vidéo, les brouillons de podcasts et les démos.
Cas d'utilisation de Seed Audio
- Créateurs de contenu : Générez des voix off pour les montages vidéo, bandes-annonces et storyboards avec des balises de livraison expressives
- Podcasteurs : Produisez des ébauches de podcasts et des épisodes de dialogue multi-voix en utilisant la génération de dialogue multi-voix
- Annonceurs : Créez des maquettes publicitaires et des voix off de démonstration de produits avec des styles de livraison chaleureux, cinématographiques ou naturels
- Développeurs de jeux : Générez des dialogues de personnages et des voix off narratives pour les prototypes de jeux et storyboards
- Monteurs vidéo : Produisez rapidement des ébauches de voix off pour les montages bruts, revues clients et exports vidéo finaux
FAQ de Seed Audio
Qu'est-ce que Seed Audio ?
Seed Audio est un outil de synthèse vocale (Text-to-Speech) et de texte en dialogue propulsé par l'IA, basé sur la technologie ElevenLabs et intégré à la plateforme NanoPhoto. Il convertit des scripts écrits en audio parlé avec des balises d'interprétation expressives, la prise en charge de dialogues à plusieurs voix et un aperçu rapide en MP3. Les utilisateurs écrivent ou collent un script, choisissent une voix, ajoutent éventuellement des instructions de jeu et génèrent un audio audible en quelques secondes sans quitter le navigateur.
Quelle est la différence entre la synthèse vocale et le texte en dialogue ?
La synthèse vocale (TTS) génère une voix off d'un seul narrateur à partir d'un bloc de texte, idéale pour les vidéos explicatives, les lectures de publicités et les brouillons de voix off. Le texte en dialogue attribue différentes voix aux différentes répliques d'un script, prenant en charge les conversations à plusieurs intervenants pour les podcasts, les dialogues de jeux, les démos et les storyboards. Le mode dialogue accepte également des balises d'interprétation par réplique, permettant de diriger indépendamment le jeu de chaque personnage.
Quelles balises d'interprétation sont prises en charge ?
Seed Audio reconnaît des balises telles que [laughing], [whispering], [sighs], [short pause], [warmly], [curious] et d'autres qui orientent le ton émotionnel et le rythme de la sortie. Ces balises sont insérées directement dans le texte du script à l'endroit où l'interprétation doit changer. Elles fonctionnent à la fois en mode TTS et en mode dialogue, offrant aux utilisateurs un contrôle précis sur la sonorité d'une ligne sans nécessiter de montage audio externe.
Comment fonctionne la tarification de Seed Audio ?
Seed Audio utilise un modèle de tarification basé sur des crédits, où chaque génération audio coûte 1 crédit. Les crédits sont achetés via la plateforme NanoPhoto et s'appliquent à l'ensemble de la suite de produits. Ce modèle de paiement par génération convient aux utilisateurs dont la charge de travail varie, des brouillons de voix off occasionnels à la production de dialogues à volume élevé, sans nécessiter d'abonnement mensuel.
À qui Seed Audio est-il destiné ?
Seed Audio cible les créateurs de contenu, les monteurs vidéo, les podcasteurs, les développeurs de jeux et les équipes produit qui ont besoin d'actifs vocaux rapides et publiable. Il s'intègre dans les flux de travail où la vitesse compte, comme les maquettes publicitaires, les voix off de tutoriels, les dialogues de personnages pour les jeux indépendants et les enregistrements de brouillons de podcasts. Les utilisateurs qui devaient autrement ouvrir un studio audio dédié pour chaque script court peuvent accomplir la même tâche en une fraction du temps.
Quels formats audio Seed Audio produit-il ?
Seed Audio génère des fichiers MP3 qui peuvent être prévisualisés directement dans le navigateur et téléchargés pour être utilisés dans des logiciels de montage vidéo, des outils de production de podcasts, des moteurs de jeu et des présentations. Le MP3 a été choisi comme format de sortie pour son équilibre entre taille de fichier et qualité audio, ce qui le rend pratique aussi bien pour les brouillons rapides que pour les actifs finaux.
Comment Seed Audio se compare-t-il aux outils TTS autonomes ?
Contrairement aux outils TTS autonomes qui nécessitent de passer d'une application à l'autre pour l'édition du script, la sélection de la voix et l'exportation audio, Seed Audio maintient l'ensemble du flux de travail au sein de la plateforme NanoPhoto. Les utilisateurs écrivent, dirigent, rendent, écoutent et téléchargent dans une seule interface. Le système intégré de balises d'interprétation et le mode dialogue multi-intervenants éliminent le besoin de sessions de montage audio séparées pour les ajustements de base de l'interprétation, réduisant le temps d'itération de minutes à secondes par génération.
Comment utiliser Seed Audio
- Rédigez le script source en saisissant un paragraphe de voix off ou deux à quatre tours de dialogue, ou quatre tours axés sur une parole naturelle.
- Choisissez les voix et le rendu en sélectionnant une voix de narrateur pour la synthèse vocale (TTS) ou en attribuant une voix différente à chaque tour de dialogue pour un échange entre personnages.
- Ajoutez des indications de jeu comme [warmly] (chaleureusement), [curious] (curieusement), [laughing] (en riant) ou [short pause] (courte pause) pour guider l'expressivité émotionnelle et donner un résultat dirigé.
- Prévisualisez le MP3 généré dans le navigateur pour vérifier la qualité, puis téléchargez le fichier audio pour le montage vidéo, les brouillons de podcast, les maquettes publicitaires ou les démonstrations produit.
Seed Audio Analyse du trafic sur le site web
Dernières informations trafic
- Visites mensuelles127.48K
- Taux de rebond40.7%
- Pages par visite1.76
- Durée de la visite00:00:37
- rang global340.66K
- Classement des pays/régions33.75K
Mots-clés principaux
| Mot-clé | Trafic | Le volume | Coût par clic |
|---|---|---|---|
| nano banana | 380 | 1.64M | $0.7 |
| 视频提示词反推 | 320 | 310 | -- |
| nano photo ai | 240 | 240 | -- |
| subtitle remover | 230 | 2.2K | $0.2 |
| nanophoto ai | 230 | 490 | -- |
Principales régions
| Région | Pourcentage |
|---|---|
| Chine | 49.75% |
| États-Unis | 4.69% |
| Malaisie | 3.47% |
| Taïwan | 3.14% |
| Inde | 2.22% |
Seed Audio Alternatives
LOVO AI transforme vos textes en voix off MP3 dans le navigateur, avec 21 extraits audio, clonage vocal autorisé, synthèse en 74 langues et éditeur vidéo.

Play HT est un générateur de voix IA gratuit qui transforme du texte en parole, avec plus de 200 voix publiques, une écoute dans le navigateur et un export MP3.
MixVio exécute 21 modèles vidéo, image et audio dans un espace de travail navigateur, ajoute 11 outils pour les créateurs et affiche le coût exact en crédits avant chaque génération.
PodcastorAI transforme des PDF, des liens, des notes et de l'audio en vidéos de podcast de qualité studio pour YouTube, Spotify et TikTok, avec animateurs IA, voix et scripts.
KidVoice est un générateur de voix enfantine par IA qui crée des voix naturelles d'enfants et d'adolescents à partir de texte, avec support multilingue et clonage vocal.
Miso One AI est un générateur de voix IA qui permet aux créateurs et aux équipes de développement de créer des audios de dialogues expressifs, de tester le clonage, de réviser les prompts et de télécharger des échantillons vocaux avec suivi des crédits.
Petti Chat est un outil web alimenté par l'IA qui permet aux propriétaires d'enregistrer de courts sons de leurs animaux, d'en interpréter l'intention probable en langage humain, puis de répondre par un audio calme et adapté aux animaux, tout en assurant la confidentialité et l'interaction en temps réel.
GPT Realtime 2 est un générateur de voix IA destiné aux développeurs et aux équipes produit, offrant une interaction parole‑à‑parole en temps réel, un audio à faible latence, un contrôle des invites, des transferts d’outils et la possibilité de télécharger les enregistrements de session.
GPT Realtime est une plateforme de génération de voix IA destinée aux développeurs et aux équipes produit, proposant du speech‑to‑speech à faible latence, des invites intégrant des images, la prise en charge des appels SIP, la planification de flux de travail API et un cache réutilisable pour prototyper rapidement des applications vocales.
Ce lecteur PDF en ligne avec voix utilise l'IA pour convertir des documents, y compris des fichiers numérisés via OCR, en parole naturelle dans plus de 142 langues, prenant en charge tous les formats PDF.
AnySpeech est une plateforme professionnelle de synthèse vocale IA offrant plus de 100 voix réalistes dans plus de 50 langues, conçue pour les créateurs de contenu, les YouTubers et les podcasteurs du monde entier.
Le générateur de voix FineVoice AI permet aux créateurs de convertir le texte en parole avec des voix IA réalistes et de cloner des voix dans n'importe quel style ou langue facilement.